Cómo se entrena un sistema de IA para el análisis de resonancias magnéticas: pasos clave
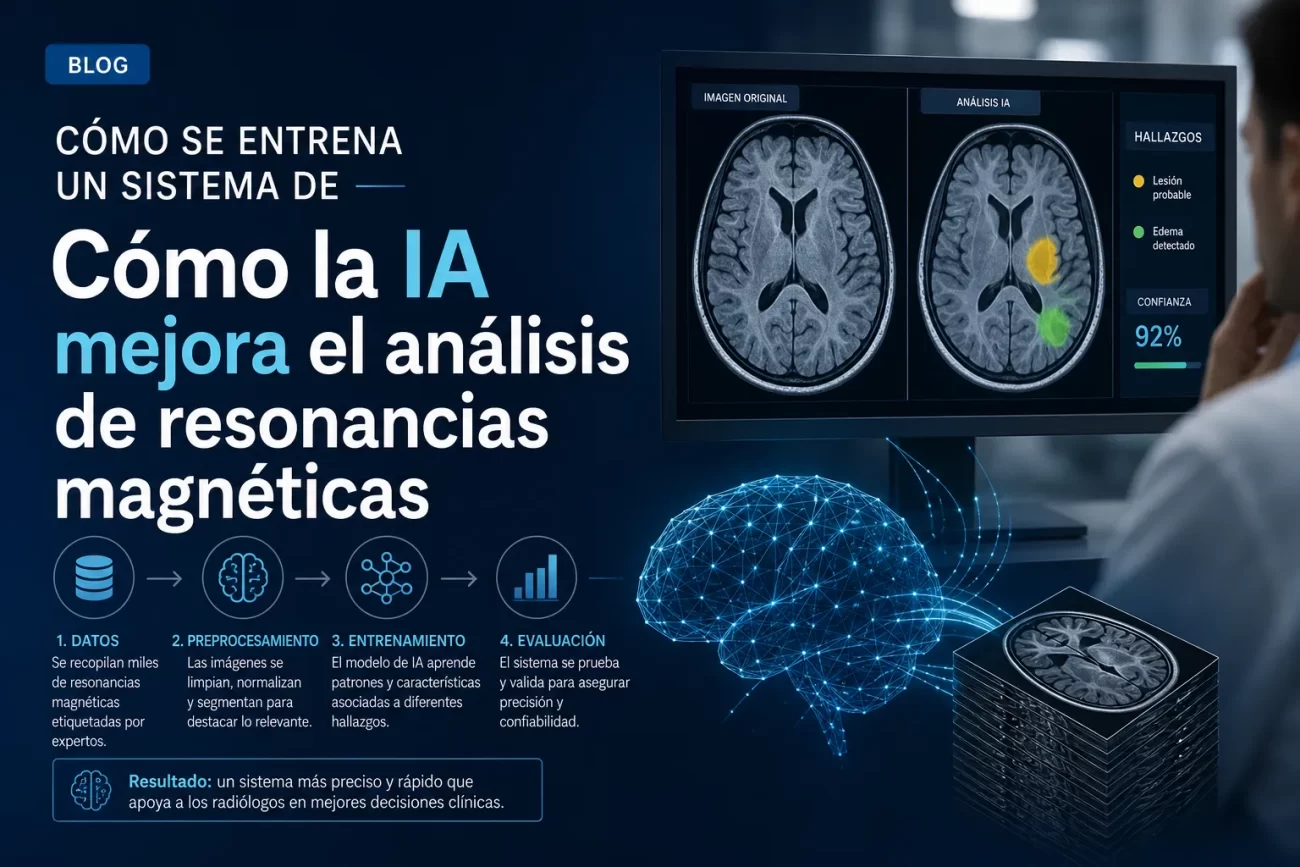
Entrenar un sistema de IA para el análisis de resonancias magnéticas comienza con definir el objetivo clínico y reunir conjuntos de datos representativos y éticos. Es imprescindible la anonimización y la selección de imágenes con diversidad de protocolos, anatomías y patologías para evitar sesgos. Un equipo multidisciplinario (radiólogos, ingenieros y especialistas en datos) guía la calidad de las imágenes y las reglas de anotación.
Pasos clave
- Recolección y curación: agregación, anonimización y armonización de series MR.
- Anotación clínica: etiquetas y segmentaciones por expertos con protocolos de consenso.
- Preprocesamiento: normalización de intensidad, registro, corrección de artefactos y aumento de datos.
- División y entrenamiento: separación en entrenamiento/validación/prueba, selección de arquitectura (p. ej. modelos de aprendizaje profundo) y ajuste de hiperparámetros.
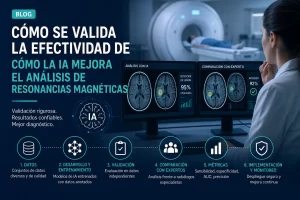
- Evaluación: métricas relevantes según la tarea (por ejemplo Dice para segmentación, AUC para clasificación) y validación cruzada y externa.
Después del entrenamiento, se realizan pruebas de robustez frente a variaciones de escáner y protocolos, análisis de errores y técnicas de interpretabilidad para apoyar la confianza clínica. La validación externa y, cuando procede, estudios prospectivos son pasos clave para demostrar generalizabilidad y seguridad antes de uso real en pacientes.
Para el despliegue se contempla la integración con sistemas PACS/HIS, la monitorización post-despliegue y la actualización controlada del modelo con nuevos datos anotados. Todo el ciclo de entrenamiento y uso debe cumplir requisitos de privacidad, gobernanza de datos y regulación sanitaria aplicable.
Preparación de datos y anotación: qué imágenes, etiquetas y calidad necesita la IA
Para entrenar modelos de visión, la selección de imágenes debe priorizar la representatividad y la diversidad: escenarios, ángulos, edades, razas, condiciones de iluminación y dispositivos de captura que reflejen el uso real. Las imágenes deben tener resolución suficiente para las tareas previstas (por ejemplo, detección de objetos suele requerir mayor detalle que clasificación) y un formato sin compresión excesiva que introduzca artefactos. Evita duplicados y frames casi idénticos; incorpora metadatos (fecha, dispositivo, ubicación) para control de sesgo y trazabilidad.
La anotación necesita pautas claras y documentadas: definición de clases, nivel de granularidad (etiqueta de imagen, bounding box, segmentación pixel a pixel, keypoints), y criterios de inclusión/exclusión. Es fundamental la consistencia entre anotadores mediante ejemplos, instrucciones y métricas de control de calidad como la acuerdo inter-anotador. Registra versiones de las etiquetas y usa formatos interoperables (COCO, Pascal VOC, JSON) para facilitar validación y auditoría.
Para garantizar calidad, aplica controles automáticos y manuales: validación de formatos, comprobación de superposiciones imposibles, verificaciones de resoluciones y relación señal/ruido. Tipos de anotación comunes:
- Clasificación: etiqueta global por imagen.
- Detección: bounding boxes con coordenadas precisas.
- Segmentación: máscaras pixel-level para contornos exactos.
- Keypoints/Landmarks: puntos con tolerancia definida.
Establece umbrales mínimos de precisión para boxes/máscaras y revisa muestras aleatorias para corregir sesgos o errores sistemáticos.
Finalmente, la calidad del dataset incluye tamaño y balance adecuados: suficientes ejemplos por clase, estrategias para clases raras (más muestreo o anotación dirigida) y particiones limpias de entrenamiento/validación/prueba que preserven la distribución real. Mantén un ciclo de revisión continua donde se reanoten y actualicen imágenes problemáticas y se monitorice el impacto de la calidad de anotación en las métricas del modelo.
Modelos y técnicas de aprendizaje (CNN, transferencia de aprendizaje y redes 3D) para resonancias
Las CNN (redes convolucionales) son la base más utilizada para el procesamiento de resonancias magnéticas por su capacidad para extraer características locales y jerárquicas en imágenes. En tareas como segmentación de tejidos, detección de lesiones y clasificación de patologías, arquitecturas inspiradas en U-Net, ResNet o variantes encoder-decoder permiten aprender mapas de características relevantes directamente de los cortes de RM, mejorando la precisión frente a métodos basados en características manuales. En aplicaciones clínicas y de investigación, las CNN se emplean tanto en procesamiento 2D por corte como en flujos que integran información multi-secuencia (T1, T2, FLAIR) para robustecer la representación.
La transferencia de aprendizaje facilita el entrenamiento cuando los conjuntos de datos anotados de resonancias son limitados: modelos preentrenados en grandes corpus (por ejemplo ImageNet) se ajustan (fine-tuning) a imágenes médicas, o se realiza preentrenamiento en dominios médicos cercanos antes de la adaptación a RM. Esta técnica reduce el tiempo de convergencia y la necesidad de grandes etiquetas, aunque exige estrategias de adaptación de dominio y normalización de intensidades para mitigar la diferencia entre imágenes naturales y resonancias. Además, enfoques de auto-supervisión y aprendizaje por contrastes están ganando tracción como alternativas para aprovechar datos no etiquetados.
Las redes 3D abordan explícitamente la naturaleza volumétrica de las resonancias, procesando directamente cubos o volúmenes completos para capturar contexto espacial entre cortes adyacentes; modelos 3D U-Net y 3D CNNs son comunes en segmentación y cuantificación volumétrica. El principal beneficio es la mejora en coherencia espacial y precisión en estructuras tridimensionales, mientras que las limitaciones incluyen mayor coste computacional y necesidad de memoria, lo que impulsa soluciones híbridas 2.5D o estrategias de patching y downsampling para equilibrar rendimiento y recursos.
Ventajas clave
- CNN: extracción automática de características y adaptabilidad a tareas de segmentación y clasificación.
- Transferencia de aprendizaje: reducción de datos anotados necesarios y aceleración del entrenamiento.
- Redes 3D: mejor captura del contexto volumétrico y coherencia entre cortes, útil para análisis volumétricos.
Validación, métricas y despliegue clínico: garantizar precisión, robustez y seguridad
Validación, métricas y despliegue clínico son pilares imprescindibles para que cualquier herramienta sanitaria basada en datos cumpla con estándares de precisión, robustez y seguridad. La validación debe incluir pruebas internas y validación externa en cohortes independientes, evaluación de sesgo por subgrupos y análisis de estabilidad frente a variaciones en la adquisición de datos. Además, la documentación reproducible y el alineamiento con requisitos regulatorios facilitan la adopción clínica y la confianza de profesionales y pacientes.
Métricas clave para evaluar desempeño
- Sensibilidad y especificidad: para medir detección y falsos positivos.
- Curva ROC / AUC y Precisión-Recall: útiles según prevalencia de la condición.
- Calibración: concordancia entre probabilidades predichas y observadas.
- F1, valores predictivos y tasas de error: para balancear precisión y cobertura.
- Evaluaciones de robustez y pruebas de estrés: para medir rendimiento ante datos ruidosos o cambios poblacionales.
Estas métricas, complementadas con análisis de equidad y explicabilidad, permiten una decisión informada sobre la idoneidad clínica del sistema.
El despliegue clínico exige un plan de implementación que incluya validación prospectiva en el entorno operativo, monitorización continua de rendimiento, gestión de actualizaciones y mecanismos de reporte de incidentes para garantizar la seguridad del paciente. La interoperabilidad con sistemas clínicos, la protección de datos y los protocolos de gobernanza son fundamentales para mantener la robustez y permitir auditorías que confirmen que las métricas observadas en producción se mantienen alineadas con las de validación.
Cómo la IA mejora el análisis de resonancias magnéticas: beneficios clínicos, limitaciones y consideraciones éticas
La incorporación de la IA en el análisis de resonancias magnéticas optimiza la extracción de información cuantitativa y cualitativa de las imágenes, mejorando la sensibilidad y la consistencia en la detección de lesiones. Modelos de aprendizaje automático y redes neuronales facilitan tareas como la segmentación automática, la detección de anomalías sutiles y la extracción de biomarcadores imagenológicos, lo que acelera el flujo de trabajo radiológico sin sacrificar la calidad diagnóstica.
Entre los principales beneficios clínicos se encuentran una mayor precisión y reproducibilidad en el diagnóstico, el apoyo al diagnóstico precoz y el seguimiento cuantitativo de la enfermedad, así como la priorización de casos críticos mediante sistemas de triage automático. La IA puede reducir la carga de trabajo manual, estandarizar informes y contribuir a decisiones terapéuticas más informadas al aportar medidas objetivas y comparables a lo largo del tiempo.
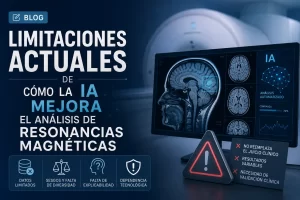
Las limitaciones actuales incluyen la dependencia de grandes volúmenes de datos anotados de calidad, la variabilidad entre equipos y protocolos de imagen (lo que puede afectar la generalización), la sensibilidad a artefactos y la limitada interpretabilidad de algunos modelos “caja negra”. Además, la validación clínica robusta y la conformidad regulatoria son requisitos necesarios antes de la integración generalizada en práctica clínica.
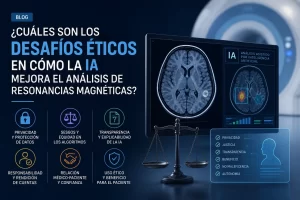
Las consideraciones éticas son clave: la protección de la privacidad de los datos de pacientes, el consentimiento informado para usos secundarios de imágenes, la mitigación de sesgos que puedan ampliar desigualdades en salud y la claridad sobre la responsabilidad clínica en caso de error. Es imprescindible que las soluciones de IA sean transparentes, auditables y se utilicen como apoyo bajo la supervisión del profesional sanitario.