¿Qué organizaciones lideran el desarrollo y cómo se entrenan modelos de IA con datos médicos?
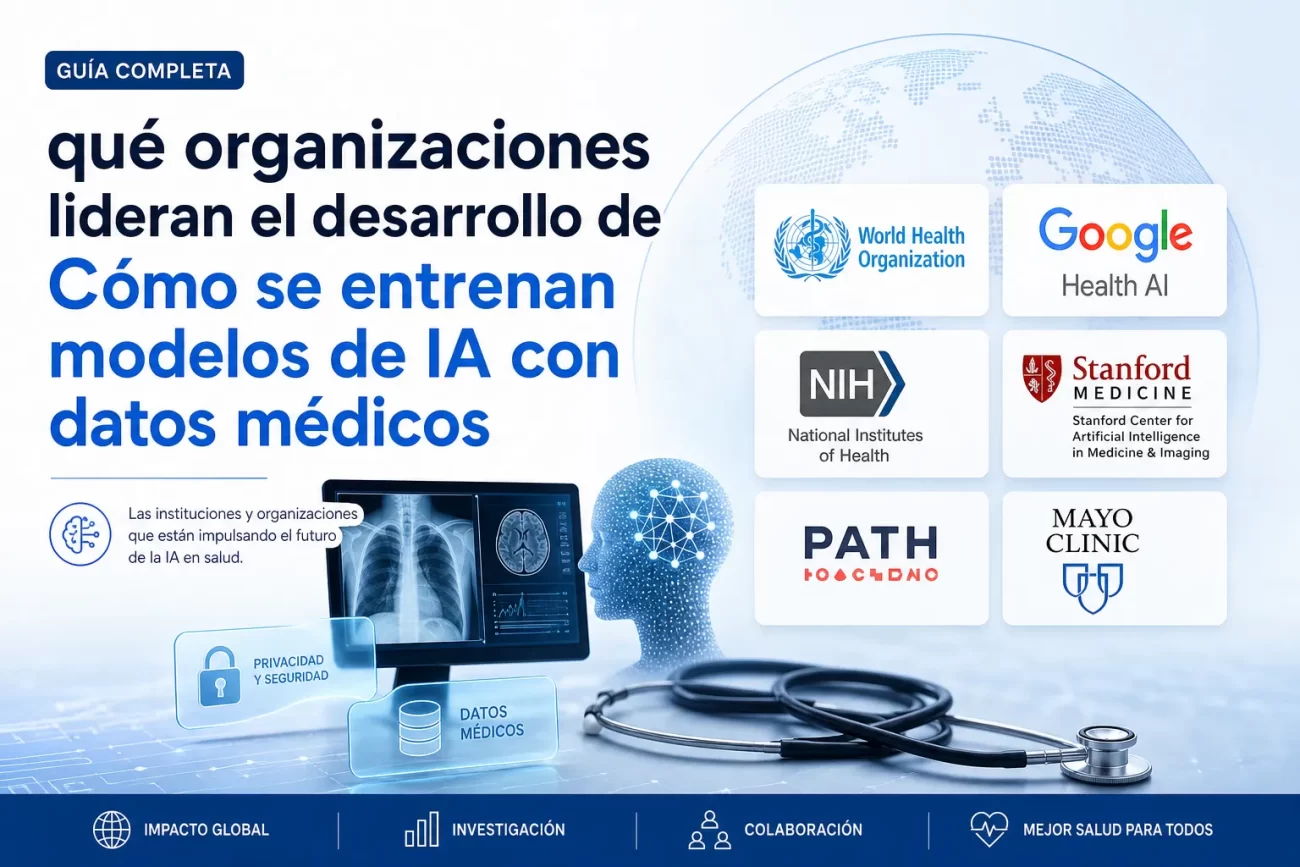
Las iniciativas de desarrollo de IA aplicada a la salud están lideradas por una mezcla de grandes empresas tecnológicas (entre las que figuran Google/DeepMind, Microsoft, Amazon y Meta), compañías especializadas en tecnología sanitaria y diagnóstico por imagen (por ejemplo, Philips, Siemens Healthineers y empresas emergentes como Tempus o PathAI), y centros académicos y hospitalarios de investigación de alto perfil (Stanford, MIT, Harvard, Mayo Clinic, NHS, NIH). También participan consorcios y repositorios colaborativos que facilitan acceso a datos clínicos y genómicos para investigación, así como entidades reguladoras que supervisan el uso clínico y la seguridad.
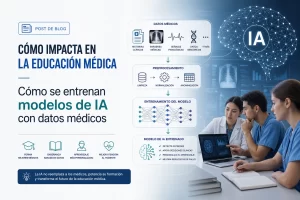
Para entrenar modelos se emplean principalmente historiales electrónicos, imágenes médicas, registros de laboratorio y cohortes poblacionales; estos datos suelen pasar por procesos de anonimización, curación y etiquetado clínico por especialistas. Ejemplos de conjuntos de datos usados en investigación incluyen:
- MIMIC y MIMIC‑CXR (registros e imágenes hospitalarias),
- CheXpert (radiografías de tórax etiquetadas),
- UK Biobank (cohorte poblacional con imágenes y genómica).
Además se emplean estándares como DICOM para imágenes y FHIR para interoperabilidad de registros.
Los enfoques de entrenamiento combinan metodologías supervisadas (con etiquetas clínicas), aprendizaje auto‑supervisado y transferencia de aprendizaje para aprovechar modelos preentrenados, además de técnicas de aumento y validación cruzada con cohortes externas. Para preservar la privacidad y cumplir normativas, se usan cada vez más técnicas como aprendizaje federado, diferential privacy, y cifrado seguro (por ejemplo, cómputo multipartito o cifrado homomórfico) junto a acuerdos de uso de datos y revisiones por comités de ética.
La gobernanza del entrenamiento y despliegue incorpora revisiones por comités institucionales (IRB), contratos y acuerdos de uso de datos, y evaluaciones regulatorias cuando el software se considera dispositivo médico (intervención supervisada por agencias como la FDA o la EMA). Paralelamente, los grupos de investigación implementan pruebas de robustez, validaciones externas y métricas de equidad para mitigar sesgos antes de la puesta en práctica clínica.
Principales organizaciones (hospitales, universidades y empresas) que lideran el entrenamiento de IA con datos clínicos
Los hospitales de referencia actúan como fuentes primarias de datos clínicos para el entrenamiento de modelos de IA; instituciones como Mayo Clinic, Massachusetts General Hospital y Mount Sinai son mencionadas habitualmente por su volumen de datos, historial en investigación y colaboración con empresas tecnológicas en proyectos de aprendizaje automático aplicado a salud. Estos centros suelen combinar imágenes médicas, historiales electrónicos y cohortes clínicas para alimentar algoritmos que buscan mejorar diagnóstico, pronóstico y flujos asistenciales.
En el ámbito académico, universidades y centros de investigación impulsan metodologías, validación y publicaciones científicas sobre entrenamiento de IA con datos clínicos. Nombres como Stanford, Harvard, MIT y University of Oxford destacan por sus grupos interdisciplinarios que integran medicina, informática y bioestadística, así como por la generación de marcos abiertos y conjuntos de datos anotados que facilitan la replicabilidad y el avance científico.
Las empresas tecnológicas y del sector salud proporcionan infraestructuras, plataformas y experiencia en escalado de modelos; actores como Google Health / DeepMind, IBM Watson Health, Microsoft, NVIDIA, Amazon Web Services, Philips y Siemens Healthineers colaboran con hospitales y universidades para entrenar y desplegar soluciones basadas en datos clínicos, poniendo énfasis creciente en gobernanza de datos, privacidad y cumplimiento normativo durante el desarrollo de modelos.
Métodos y mejores prácticas: cómo entrenan las organizaciones modelos de IA con datos médicos
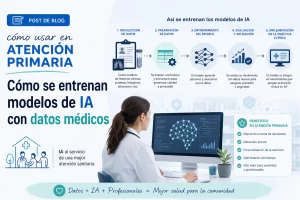
Para entrenar modelos de IA con datos médicos, las organizaciones suelen establecer marcos de gobernanza de datos que priorizan el consentimiento informado, la minimización de datos y la seudonimización o desidentificación para proteger la privacidad del paciente. Es buena práctica incorporar requisitos regulatorios y éticos (p. ej., cumplimiento de GDPR/HIPAA cuando aplica) desde la fase de diseño, mantener registros de trazabilidad de los consentimientos y aplicar controles de acceso y auditoría sobre los conjuntos de datos clínicos. La protección de la privacidad y la transparencia en el uso de datos son pilares que condicionan tanto la recopilación como el etiquetado y el intercambio de información.
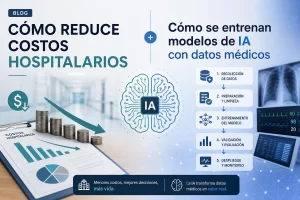
En la fase técnica, la calidad y consistencia de los datos son imprescindibles: normalización de formatos, limpieza de registros, etiquetado estandarizado por especialistas y revisión interanotador para reducir ruido y sesgos en las etiquetas. Se emplean estrategias como muestreo estratificado, aumento de datos y balanceo de clases para abordar la falta de representatividad, así como técnicas de preservación de la privacidad —por ejemplo, aprendizaje federado o generación de datos sintéticos— cuando el traslado de datos sensibles no es viable. La documentación del ciclo de vida de los datos (metadatos, protocolos de anotación, versiones) facilita la reproducibilidad y la auditoría posterior.
Durante el desarrollo y despliegue, las mejores prácticas incluyen validación robusta con particiones temporales y validaciones externas independientes, métricas ajustadas al problema clínico y pruebas de equidad para detectar sesgos por edad, sexo, origen étnico u otras variables relevantes. Además, se recomienda implementar monitoreo continuo del rendimiento en producción, mecanismos de gestión de deriva de datos, procedimientos de reversión seguros y explicabilidad suficiente para usuarios clínicos; todo ello apoyado por entornos de cómputo seguros, control de versiones del código y revisiones por pares para garantizar responsabilidad y trazabilidad en modelos que usan datos médicos.
Datasets, protocolos y regulación: estándares que siguen las organizaciones líderes en IA sanitaria
Calidad y trazabilidad de los datasets: Las organizaciones líderes en IA sanitaria priorizan conjuntos de datos heterogéneos y bien documentados (imágenes médicas, historiales clínicos electrónicos, datos genómicos) con metadatos que permitan evaluar procedencia, sesgos y representatividad. Se exigen procesos de anotación estandarizados y auditoría de etiquetas para garantizar reproducibilidad, así como técnicas de desidentificación y gestión del consentimiento que cumplan la normativa de privacidad aplicable. La gobernanza de datos incluye acuerdos de acceso, registros de versiones y medidas para minimizar el sesgo poblacional en fases tempranas del desarrollo.
Elementos clave
- Calidad y limpieza de datos con protocolos de control.
- Representatividad demográfica y clínica para reducir disparidades.
- Trazabilidad y documentación de procedencia y transformaciones.
- Limitación de identificación y cumplimiento de consentimiento informado.
Protocolos de validación y transparencia: Los estándares recomiendan validación externa, evaluación prospectiva en entornos clínicos reales y seguimiento post-implantación para medir rendimiento en práctica. Para la comunicación y auditoría, se adoptan marcos de reporte y documentación (por ejemplo, guías específicas para estudios de IA médica, tarjetas de modelo y formatos interoperables como FHIR) que facilitan la reproducibilidad y la interpretación clínica de resultados.
Regulación y vigilancia: Las organizaciones se alinean con marcos regulatorios y de protección de datos relevantes (por ejemplo, GDPR o HIPAA en materia de privacidad; marcos regulatorios de autoridades sanitarias como FDA o EMA en lo relativo a dispositivos de software sanitario) y con iniciativas legislativas sobre IA que introducen clasificación de riesgo y requisitos de seguridad y transparencia. Además, implementan sistemas de gestión de calidad y vigilancia post-comercialización para detectar degradación del rendimiento, gestionar riesgos y actualizar modelos según cambios en la práctica clínica o la población.
Proyectos y casos de éxito: ejemplos de organizaciones que lideran el desarrollo de IA con datos médicos
Estas iniciativas muestran cómo la combinación de IA y datos médicos avanza desde la investigación hasta aplicaciones clínicas reales. Grandes grupos tecnológicos, hospitales académicos, consorcios de datos y startups han liderado proyectos que aprovechan imágenes médicas, registros electrónicos y cohortes poblacionales para entrenar modelos, siempre con enfoque en validación clínica, privacidad y cumplimiento regulatorio.
Ejemplos destacados
- DeepMind – Moorfields: colaboración en modelos de imagen ocular para apoyar el diagnóstico en oftalmología.
- IDx-DR: empresa con una herramienta autónoma para detección de retinopatía diabética que obtuvo autorización regulatoria.
- Stanford (CheXpert / CheXNeXt): iniciativas académicas que desarrollaron conjuntos de datos y modelos para interpretación de radiografías torácicas.
- MIT / PhysioNet (MIMIC): repositorios de datos clínicos ampliamente usados por la comunidad para investigación en IA y medicina intensiva.
- Apple / estudios clínicos: proyectos colaborativos para detectar fibrilación auricular a partir de señales de dispositivos wearables.
- Flatiron, Tempus: empresas que integran datos oncológicos y genómicos para impulsar modelos de soporte a la toma de decisiones en cáncer.
Estos casos de éxito comparten elementos comunes: equipos multidisciplinares, acceso a datos clínicos curados, validación contra estándares médicos y diálogo con reguladores y centros sanitarios para la implementación. El aprendizaje principal es que el impacto clínico de la IA con datos médicos depende tanto de la calidad del dato y la validación como de las alianzas entre tecnología, investigación y práctica clínica.